この記事では、A2A(Agent2Agent Protocol) で外部のAgentに仕事を頼むとき、自社に返ってくる情報だけで、外部のAgentの品質とトークン消費をどこまで測れるかを検証しました。今回やったことは次の3つです。
- 正解を付けたDatasetで、外部のAgentが返した判定を採点する(品質)
- 外部のAgentに、使ったトークン数を返してもらう取り決めを作る(コスト)
- 外部のAgentのモデルを差し替え、結果と記録がどう変わるかを比べる
コストは、外部のAgentから教えてもらったトークン数で比べます。料金そのものは計算していません。
この検証が必要なのは、A2Aでは外部のAgentの中が見えないからです。別のチームや外部の事業者が運用するAgentに仕事を頼むと、返ってくるのは仕事の状態(処理中、完了、失敗など)と結果です。A2Aの仕様には、外部のAgentがどのモデルを使い、何トークン消費し、どんな指示(プロンプト)で判断したかを返す標準の欄がありません。
構成は前回の記事 と同じで、文章を書くDraft Agentと、それをレビューするReview Agentの通信をagentgateway で中継しています。今回はReview Agentを外部のAgentに見立てました。
想定読者#
- A2Aで複数のAgentを連携させる構成を検討している方
- 自社で作っていないAgentを、自社のAgentやワークフローから呼び出す予定がある方
- Langfuse でLLMアプリの評価や観測をしている方
検証した構成と用語#
flowchart LR
    subgraph 自社
        C[Draft Agent
または評価用クライアント]
        G[agentgateway]
        L[Langfuse]
    end
    subgraph 外部の組織に見立てる
        R[Review Agent]
        V[Gemini
Gemini Enterprise
Agent Platform]
    end
    C -->|A2Aでレビューを依頼| G -->|A2A| R
    R -->|判定・点数・コメント| G --> C
    R -->|LLM呼び出し| V
    C -.->|トレース| L
    G -.->|トレース| L
    R -.->|トレース
送る/送らないを切り替え| L
| 用語 | この記事での意味 |
|---|---|
| 自社 | Draft Agent・評価用クライアント・agentgateway・Langfuseを運用する組織。この記事の読者の立場 |
| 外部のAgent | 別の組織が運用し、自社からは中身を見られないAgent。この記事ではReview Agentがその役 |
| 評価用クライアント | Review Agentにレビューを依頼するプログラム。品質の評価では、Draft Agentの代わりにこれを使う |
| Task | A2Aで頼んだ仕事1件の単位。処理中、完了、失敗などの状態と、ID(Task.id)を持つ。関連する仕事はcontextIdでまとめられる |
| Artifact | Taskの成果物として、仕事を頼まれたAgentが返すもの。この記事ではレビューの判定、点数、コメント |
| Review Agentの内部処理 | Review Agentの中で起きたことの記録。使ったモデル、トークン数、プロンプト、LLM呼び出しなど。標準のA2Aの応答には含まれない。以下「内部処理」と略す |
| 自社のトレース | Langfuseに残るトレースのうち、自社(Draft Agent・評価用クライアント・agentgateway)が送った記録だけのもの。外部のAgentに頼んだときに自社で見える範囲 |
| 全体のトレース | 自社のトレースに、Review Agentが送った記録も加えたもの。自社のトレースで何が欠けるかを見る比較用 |
再現したのは、Draft Agent・評価用クライアント・agentgatewayの記録は自社で見られ、Review Agentの内部処理は見られない状況です。agentgatewayは自社で運用する前提です。全体のトレースを取る実行だけは、Review Agentからもトレースを送っています。トレースはOpenTelemetryで記録し、Collector経由でLangfuseへ送りました。
わかったこと#
- Review Agentの中身が見えなくても、今回のDatasetに対する判定精度は測れました。筆者が正解ラベルを付けた文章24件をReview Agentへ3周送り、Review Agentが返した判定を正解ラベルと突き合わせたところ、見逃し率16.7%、過剰指摘率0%でした。
- Review Agentが使ったトークン数は、教えてもらわないと分かりません。A2Aの応答には、トークン数(コストの元になる値)を返す標準の欄がないためです。Artifactの
metadataに載せて返してもらう取り決めを入れて、初めて自社で見えるようになりました。今回はReview Agentも自作なので照合でき、返ってきた値は72件すべてでReview Agent自身の記録と一致しました。外部のAgentでは、そのAgentの自己申告として扱う値です。 - Review AgentでTaskが失敗しても、agentgatewayのアクセスログには表れませんでした(ストリーミング送信時、今回の検証環境)。モデルを差し替えた検証で72件中14件のTaskが失敗しましたが、アクセスログは失敗したものも含めてすべてHTTP 200でした。失敗に気づけたのは、評価用クライアントが受け取ったTaskの状態からです。
- Review Agentのモデルを
gemini-3.5-flash-liteからgemini-3.8-flashに変えると、見逃し率は16.7%から8.3%に下がりました。その代わり、過剰指摘率は0%から2.8%になり、トークン数は約35%増えました(出力の上限を4096トークンに直した後の結果。思考の既定値もモデルごとに異なるため、モデル単体ではなく設定を含めた組み合わせの比較です)。見逃し、過剰指摘、トークン数のどれも自社に届く情報から分かるので、モデルを比べる材料になります。
A2Aで受け取れる情報#
今回のようにTaskを返すAgentでは、応答からTaskの状態、Task.id、contextIdを確認できます。成果物として返されたArtifactも取得でき、やり取りの往復回数と所要時間は自社側で計測できます。
それ以外の情報について、A2Aの仕様は次のように書いています。
| 論点 | 仕様の記述 | 出典 |
|---|---|---|
| 内部を共有しない前提 | Agentが「互いの内部状態、記憶、ツールにアクセスする必要なく」連携できることを目指す。内部の記憶やツールを共有しないため、典型的には「opaque(中が見えない)」である | Specification 1.1 、Enterprise Features |
| トークン数・コスト | Task、Message(依頼や応答そのもの)、Artifactに、トークン数やコストを返す標準の欄はない | Specification 4.1 |
| 独自の情報の載せ方 | Task、Message、Artifactには任意のmetadataがある。Agent CardではExtension(標準にない機能への対応を宣言する欄)を宣言できる | Specification 4.1、4.4.4 |
| 分散トレーシング | クライアントとサーバーは分散トレーシングに参加する「べき(should)」とされる | Enterprise Features |
トレースIDを外部のAgentへ引き継ぐこと(トレースの伝播)は推奨であって、必須ではありません。外部のAgentが分散トレーシングに対応していても、そのトレースは外部のAgent自身の監視ツールに送られます。自社のLangfuseに、外部のAgentの内部処理が表示される保証はありません。
今回の構成でログとトレースに残った情報#
前回の記事と同じ処理(Draft Agentが初稿を書き、Review Agentに2回レビューを頼む)を11回実行し、どこに何が記録されるかを調べました。10回はReview Agentもトレースを送る構成(全体のトレース)、1回は送らない構成(自社のトレース)です。
次の表は、各情報がどこに記録として残るかを示します。「Draft Agent」と「Review Agentの内部」の列は、自分で記録を仕込めば残せるか。「agentgateway」の列は、標準のログやトレースに出るか、です。この表は、後述するトークン数の取り決めを入れる前の構成について示しています。
| 項目 | Draft Agent | agentgateway | Review Agentの内部 |
|---|---|---|---|
Taskの状態・Task.id・contextId | 残せる | 出ない(ストリーミング送信時) | 残せる |
| レビューの判定(Artifactの内容) | 残せる(受け取ったArtifact) | 出ない | 残せる(Review Agent自身のログ) |
| 往復の回数・所要時間 | 残せる | 出る(1往復1.2〜3.3秒) | 残せる |
| Review Agentのモデル名・トークン数 | 残せない(後述の取り決めで返してもらえば残せる) | 出ない | 残せる |
| Review Agentのプロンプト・推論の過程 | 残せない | 出ない | 一部(LLM呼び出しの記録はあるが、プロンプトと応答の文面は記録していない) |
ストリーミング送信は、応答を少しずつ受け取るA2Aのメソッド(SendStreamingMessage)です。このとき、agentgatewayのログにはcontextIdもTask.idも記録されませんでした。応答をまとめて受け取るSendMessageでは、contextIdとTaskの状態が記録されました。Task.idはどちらの場合も記録されませんでした。いずれも、agentgateway 1.5.0を使った今回の検証環境での観測結果です。
Langfuseでは、同じ処理が次のように見えました。1枚目が全体のトレース(Review Agentの記録も含む)、2枚目が自社のトレース(Review Agentの記録なし)です。
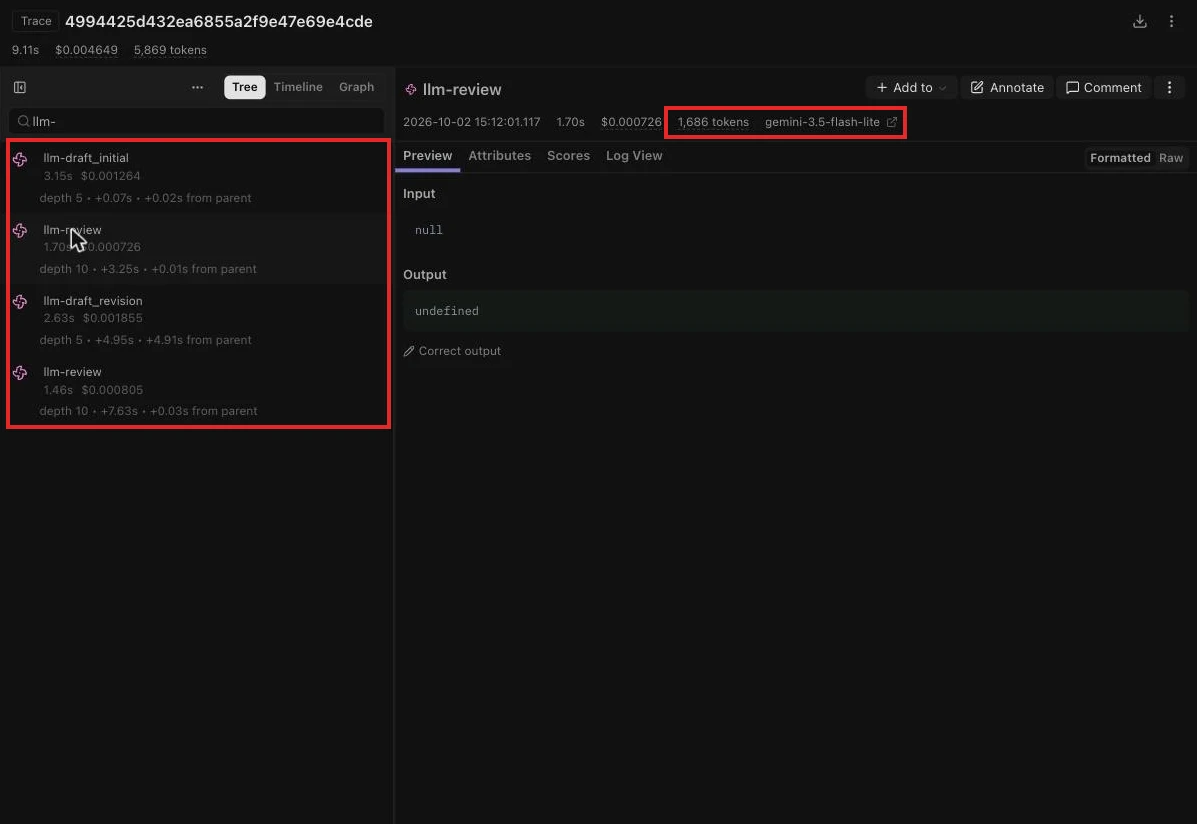
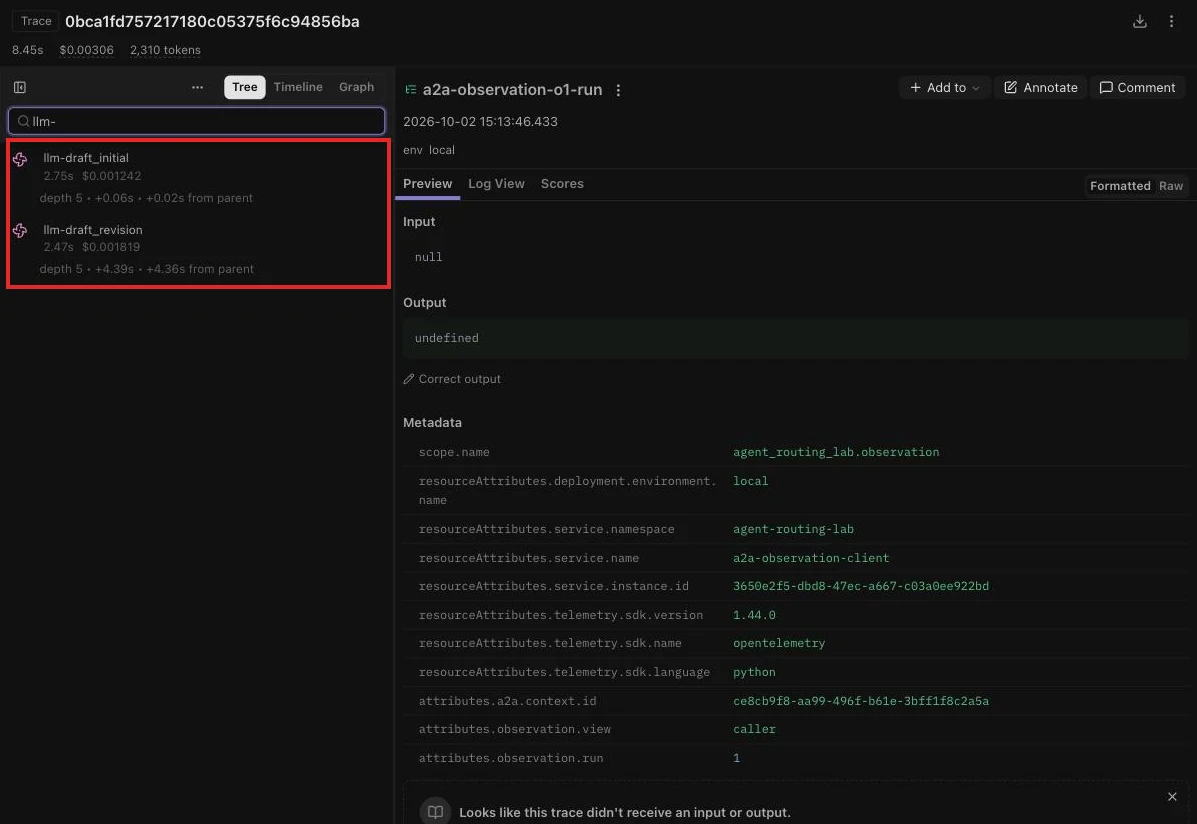
全体のトレースでは、1回の処理にspan(OpenTelemetryで処理1つ分を表す記録)が47件あり、うち10件がReview Agentのものでした。この10件にLLM呼び出し2件と、そのモデル名・トークン数が含まれます。自社のトレースはこの10件がない37件で、LLM呼び出しはDraft Agentの2件だけです。トークン数で見ると、全体のトレース10回分ではDraft Agentが24,986、Review Agentが36,474でした。半分以上を占めるReview Agentの分が、自社のトレースでは見えません。
自社のトレースでDraft Agent側に残るのは、レビュー依頼1回分のspanと、それに付けた属性です。
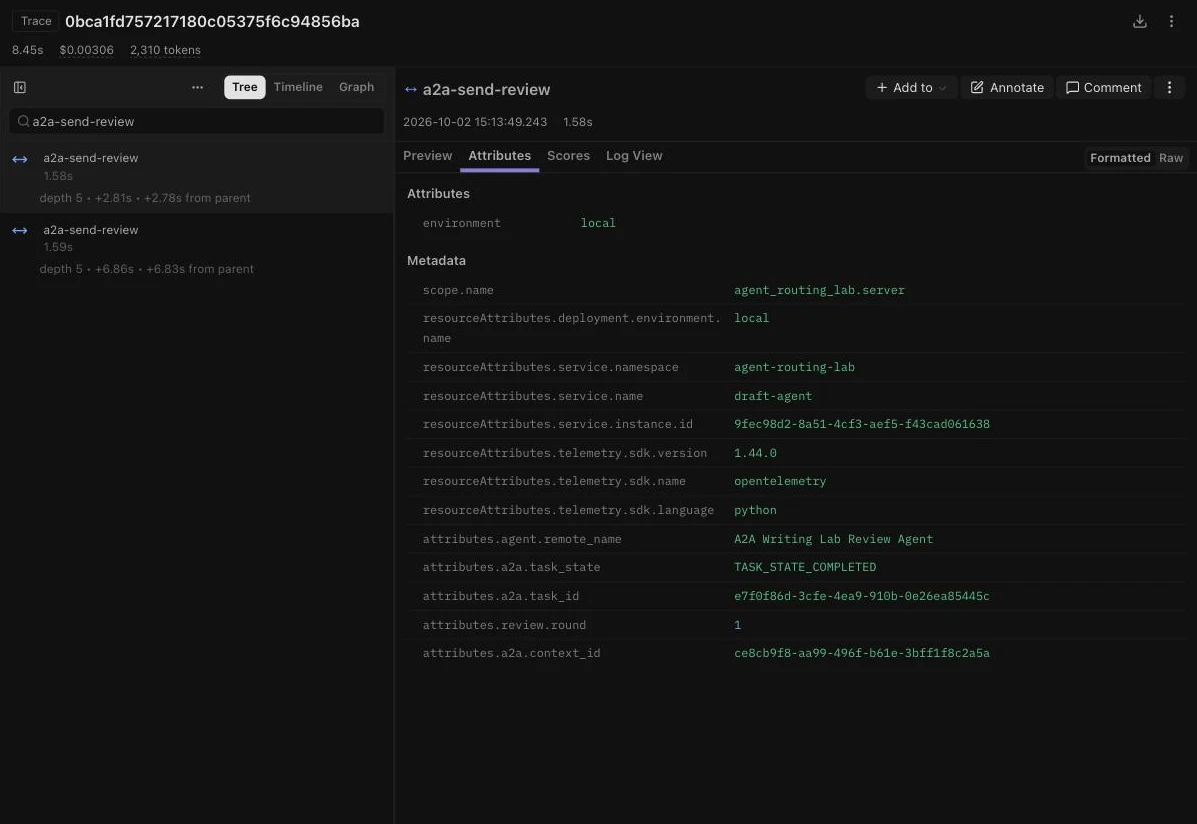
agentgatewayを置いても、Review Agentのトークン数は記録できません。agentgatewayが中継するのはAgent間の通信で、Review AgentのLLM呼び出しは通らないためです。今回の11回すべてで、agentgatewayのログとトレースにトークンの項目はありませんでした。補足すると、agentgatewayはLLMへの通信も中継でき、その場合はLLM呼び出しごとのトークン数(gen_ai.usage.input_tokensなど)がアクセスログとトレースに記録されます(筆者が別の環境のagentgateway 1.5.0で確認)。ただし記録されるのは、agentgatewayを通る自社のLLM呼び出しだけです。外部のAgentが自分の環境から直接LLMを呼ぶ分は記録できません。
判定結果による品質評価#
Review Agentの内部処理が見えなくても、Review Agentが返した判定は自社に届きます。そこで、筆者が正解ラベルを付けた文章をReview Agentへ送り、返ってきた判定が正しいかを評価用クライアントで採点しました。この節からは、Draft Agentを介さず、評価用クライアントがagentgateway経由でReview Agentにレビューを依頼します。
flowchart LR
    D[Langfuse Dataset
正解付き24件] --> E[評価用クライアント]
    E -->|A2Aでレビューを依頼| G[agentgateway]
    G -->|A2A| R[Review Agent]
    R -->|Taskの状態
判定・点数・コメント| G --> E
    E -->|採点結果をScoreに記録| L[Langfuse]
採点に使うのは、評価用クライアントに返ってきたTaskの状態と、Artifactに含まれる判定だけです。外部のAgentに依頼する場面を再現するためです。判定と筆者が付けた正解ラベルをコードで比較し、LLMによる採点は使っていません。返された点数やコメントの内容は評価していません。
評価の各周では、自社のトレースだけを取りました。Langfuseへ送るのは、評価用クライアントとagentgatewayの記録だけです。Review Agentの記録は別のログに残し、外部のAgentの監視ツールに見立てました。使うのは、返ってきたトークン数の照合と、後で述べる原因調査だけです。
Datasetの作成#
題材は前回と同じく技術記事のレビューで、Review Agentは各稿をapproved(問題なし)かneeds_revision(要修正)で判定します。測るのは、検証で確かめていないことを確かめたかのように書いた稿を、Review Agentがneeds_revisionと判定できるかです。Review Agentには各稿と一緒に、前回の検証で確認済みの事実の一覧(Agent同士の直接接続は実行していない、など)をプロンプトで渡しています。
Datasetは24件で、問題なしが12件、問題ありが12件です。問題ありのうち6件は前回の検証でDraft Agentが書いた稿のうち元から問題があったもの、残り6件は問題なしの稿に問題のある文を1つ挿入したものです。問題の中身は、「agentgatewayがTaskのIDを管理している」「試していない構成の利点を検証結果として書く」など、前回のレビューで実際に見つかったものにしました。正解ラベルは、LLMに下書きさせたものを筆者が1件ずつ読み、確定させました。
Scoreへの記録#
Langfuseでは、Datasetの全項目を1回ずつ実行した結果を、1つの実験(Dataset Run)として保存できます。今回は1周を1つの実験にしました。各項目には、Langfuseの評価値(Score)を2つ付けています。verdict_correctは判定が正解ラベルと一致したか(真偽値)、review_outcomeは結果の種類(見逃し、過剰指摘など)です。
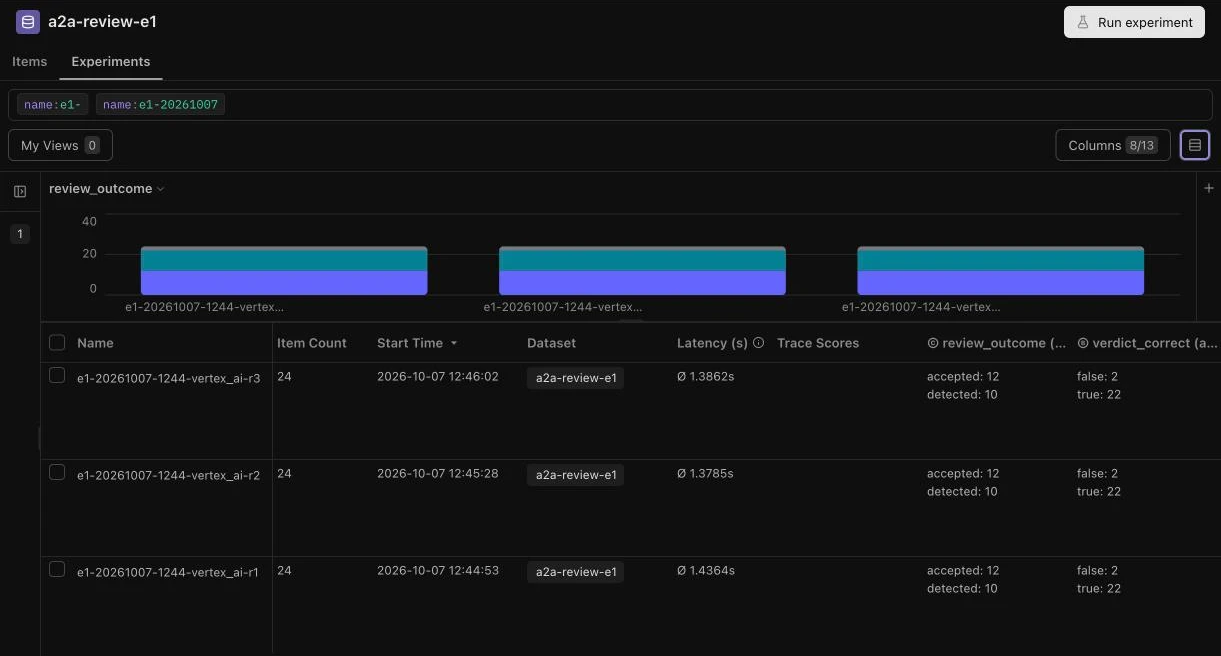
今回の構成では、実験の識別子がReview AgentへのHTTPリクエストのヘッダーにも載ります。外部のAgentを評価する場合は、実験の識別子を外部のAgentに渡してよいかを決めておく必要があります。
採点結果#
gemini-3.5-flash-liteを使うReview Agentに、24件を3周送りました。
| 指標 | 意味 | 結果 |
|---|---|---|
| 見逃し率 | 問題ありの稿をapprovedにした割合 | 16.7%(6/36) |
| 過剰指摘率 | 問題なしの稿をneeds_revisionにした割合 | 0%(0/36) |
| 正解率 | 判定が正解ラベルと一致した割合 | 91.7%(66/72) |
| 周によって判定が変わった項目 | — | 0/24 |
見逃し6回は、同じ2件を3周とも見逃したものでした。どちらも元からあった問題で、筆者が正解ラベルを付ける段階で、問題と見なすか迷った稿です。1件は、2回のレビューで「品質を段階的に向上させます」と書いた前回の最終稿です。文章品質への効果は検証していないため問題ありにしましたが、Review Agentは3周ともapprovedで、コメントは「検証で確認済みの事実と設計上の見解が混同されず正確に記述されています」でした。問題を挿入した6件は、3周ともすべてneeds_revisionと判定されました。
挿入した問題だけでDatasetを作っていたら、検出率を高く見積もるところでした。
トークン数の取り決め#
Review Agentには、Artifactのmetadataにモデル名とトークン数を載せて返してもらいます。これで、評価用クライアントでもトークン数を見られます。
Review Agentは、この取り決めに対応していることをAgent CardのExtensionとして宣言します。URIは今回の検証用に決めたもので、自社と運用者の間で任意に決められます。
AgentExtension(
    uri="urn:agent-routing-lab:a2a:usage-report:v1",
    description="Reports model and token usage of each review in Artifact metadata under 'usageReport'.",
    required=False,
)A2Aの仕様では、ExtensionはクライアントがA2A-Extensionsヘッダーで利用を要求し、サーバーが有効にします。今回の実装ではこの手順を省き、Review Agentの設定でこの取り決めを有効にすると、ヘッダーに関係なく常にusageReportを返します。そのため、この記事で確かめたのはmetadataで使用量を返す部分だけで、Extensionの有効化の手順は検証していません。
レビュー結果のArtifactには、次のようなmetadataが付きます。
{
  "usageReport": {
    "model": "gemini-3.8-flash",
    "inputTokens": 1959,
    "outputTokens": 136,
    "totalTokens": 2778
  }
}この例のtotalTokensには、入力と出力のほかに、モデルが回答前の思考(thinking)に使ったトークンも含まれています。outputTokensに思考分は含まれません。この例では、totalTokensからinputTokensとoutputTokensを引いた683トークンが思考分です。レビュー1件はLLM呼び出し1回なので、合算はしていません。
受け取った値は、評価用クライアントがspanの属性に載せます。こうすると、自社のトレースでもReview Agentのトークン数を確認できます。
前の節の24件×3周では、返ってきたトークン数が合計139,298でした。外部のAgentの監視ツールに見立てたログにあるReview Agent自身の記録と突き合わせると、72件すべてで値が一致しました。
今回の実装では、トークン数を成功したTaskのArtifactにだけ載せています。そのため、失敗したTaskのトークン消費は自社では数えられません。失敗時の消費量も必要なら、Taskや状態更新のmetadataで返す取り決めが要ります。次の節では、この制約が実際に表れました。
Task失敗の検知#
外部のAgentは、運用者の都合でモデルや設定が変わることがあります。そこで、Review Agentのモデルだけをgemini-3.5-flash-liteからgemini-3.8-flashに差し替え、同じDatasetを3周送りました。Agent Card、プロンプト、評価用クライアントの実装は変えていません。思考(thinking)の設定は未指定で、モデルの既定値です(検証環境の表を参照)。
72回のうち14回で、TaskがFAILEDで終わりました。周ごとの内訳は、1周目3件、2周目6件、3周目5件です。失敗は問題ありと問題なしの両方の稿で起き、周ごとに失敗する項目が変わりました。
アクセスログ上のTask失敗の検知#
このとき、それぞれの記録に残っていたものは次のとおりです。
| 記録 | 残っていたもの |
|---|---|
| 評価用クライアント | 失敗した14件は、Taskの状態がSUBMITTED → WORKING → FAILEDと進んだ。判定、コメント、失敗理由、トークン数は届かなかった。成功した58件では、返ってきたモデル名がgemini-3.8-flashに変わっていた |
| agentgateway | Review Agent宛てのSendStreamingMessageは、72件すべてHTTP 200だった |
| Review Agentのログ | 14件すべてで、モデルの応答をレビュー結果として解釈できなかったというエラーが記録されていた |
ストリーミング送信では、HTTPの応答自体は200で始まり、Taskの失敗はその後に流れてくるデータの中で、状態の変化として届きます。そのため、今回の検証環境では、agentgatewayのアクセスログだけを見ていてもこの失敗には気づけませんでした。筆者が気づいたのも、評価スクリプトがTaskの失敗で止まったからでした。
評価用クライアントに届くTaskの状態からは失敗率が、成功したTaskに付いてきたモデル名からはモデルの変更が分かります。そこで、評価の指標に「失敗率(TaskがFAILEDで終わった割合)」を加えました。
原因は、Review Agentがモデルに指定していた出力の上限(1024トークン)と考えられます。1周目に失敗した3件を同じ設定でGeminiに直接送り直すと、2件は終了理由がMAX_TOKENS(出力上限に到達)で、JSONが途中で切れていました。gemini-3.8-flashは回答の前に思考し、その分も上限に含まれます。ただし、これはReview Agentの運用者の立場で調べて分かったことです。外部のAgentなら、自社に分かるのは失敗率と、返ってきたモデル名の変化までで、原因の調査は運用者に頼むことになります。失敗の理由をTaskの状態(TaskStatus)のメッセージで返すかどうかも、取り決めの対象です。
修正後の再計測#
Review Agent側で出力の上限を4096トークンに広げ、同じDatasetを3周送りました。72回すべてでTaskが完了したため、出力上限の不足が主因だったと判断しました。比較は次のとおりです。
| Review Agentのモデル | 失敗率 | 見逃し率 | 過剰指摘率 | 正解率 | 周によって判定が変わった項目 | 返ってきたトークン数 |
|---|---|---|---|---|---|---|
gemini-3.5-flash-lite | 0%(0/72) | 16.7%(6/36) | 0%(0/36) | 91.7%(66/72) | 0/24 | 139,298 |
gemini-3.8-flash(上限1024) | 19.4%(14/72) | 11.1%(3/27)※ | 0%(0/31)※ | 94.8%(55/58)※ | —※ | 144,995(成功した58件分のみ) |
gemini-3.8-flash(上限4096) | 0%(0/72) | 8.3%(3/36) | 2.8%(1/36) | 94.4%(68/72) | 1/24 | 187,636 |
※ 成功したTaskだけを分母にした参考値です。失敗した項目が問題あり・なしのどちらかに偏ると、ほかの行と同じ条件では比べられません。判定が変わった項目は、失敗した周があるため算出していません。
上限を直したあとは失敗がなくなり、見逃し率は16.7%から8.3%に下がりました。一方で、問題なしの稿のうち判断が分かれそうだった1件を、1周だけneeds_revisionにしました。トークン数は、gemini-3.5-flash-liteより約35%増えています。モデルによってトークンの単価は異なるので、LLM利用料金を見積もる場合は各モデルの料金表で確認してください。
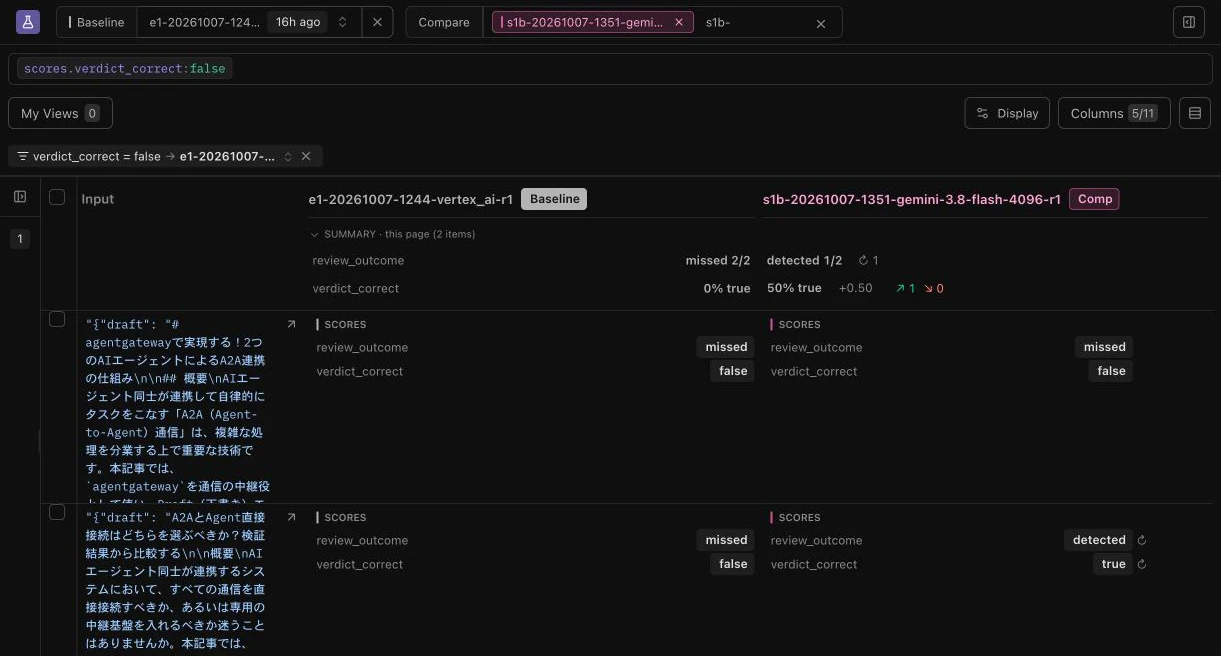
項目で数えると、見逃しの差は1件です。実際に切り替えを判断するなら、Datasetを増やして測ることをおすすめします。
今回確認していないこと#
- Review Agentは筆者が作ったものを、外部のAgentに見立てています。筆者が作ったので、Review Agentの内部の記録を使って、返ってきたトークン数の照合や失敗の原因調査ができました。実際の外部のAgentで内部の記録が共有されない場合、自社だけでは同じ確認はできず、運用者に確認を頼むことになります。
- Datasetは24件と少なく、正解ラベル(各稿が問題ありか問題なしか)は筆者1人の判断で付けました。複数人で確認したラベルではありません。
- 失敗率に数えたのは、Review AgentがTaskをFAILEDにした場合だけです。通信の切断やタイムアウトはTaskの失敗ではなく評価スクリプトの中断として扱う設計で、今回は1件も起きませんでした。
- 失敗した呼び出しのトークン消費は返ってこないため、数えられていません。
まとめ#
外部のA2A Agentを使い始めるなら、立場ごとに次のことを押さえておくと、今回のような失敗を自社で拾えます。
- 外部のAgentを選ぶ人は、トークン数とモデル名、失敗理由の返却、モデル変更の通知を、運用者との取り決めに入れる。
- 評価を組む人は、元からあった問題を含む正解付きDatasetを作り、Taskの状態も評価値として記録する。同じDatasetを定期的に流し、失敗率と、返ってきたモデル名の変化を見る。
- agentgatewayを運用する人は、アクセスログのHTTP 200を、Taskの成功とみなさない。
評価を自動化しても、正解ラベルの妥当性や、見逃した項目の中身は人が確かめる必要があります。
検証環境#
| 要素 | バージョンと条件 |
|---|---|
| agentgateway | 1.5.0、Docker Compose上のコンテナ |
| A2Aプロトコル | 1.0、JSON-RPCバインディング |
| A2A Python SDK | a2a-sdk[http-server]==1.1.2 |
| Google Gen AI SDK | google-genai==2.19.0 |
| OpenTelemetry | Python SDK 1.44.0、Collector 0.158.0 |
| Geminiモデル | gemini-3.5-flash-lite、gemini-3.8-flash(Gemini Enterprise Agent Platform、global) |
| Geminiの呼び出し設定 | thinkingは未指定(モデルの既定値。gemini-3.5-flash-liteはMINIMAL、gemini-3.8-flashはMEDIUM)。Review Agentの出力上限は1024トークン、再計測では4096トークン |
| Langfuse | Langfuse Cloud(JPリージョン) |
| Python | 3.12 |
Langfuseの画面や機能は、バージョンによって変わる可能性があります。最新の手順はLangfuseの公式ドキュメント を参照してください。