はじめに # Gemini Enterprise Agent Platform(以下、GEAP)は、Google Cloud 上でエージェントを動かし、トレースの可視化や評価まで扱うためのプラットフォームです。
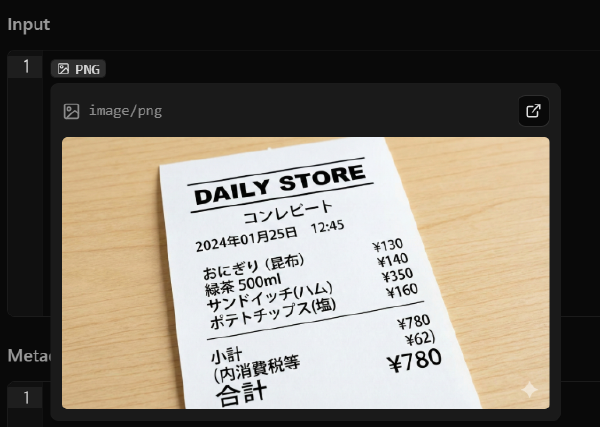
以前の記事(【入門編】Langfuseで画像OCRの精度検証をシンプルに始める方法 )では、LangfuseのDataset Itemsがマルチモーダルコンテンツを直接保持できない仕様だったため、Datasetには CSV でファイル名だけを登録し、画像実体はローカルに置いてスクリプト側で読み込む構成を取っていました。
こんにちは。ガオ株式会社の黒澤です。この記事では、前回 mem0 を Google Cloud で動かした記事 の続きとして、溜めた記憶を「運用する」段階に踏み込みます。mem0 の内部処理を Langfuse でトレースし、古くなった記憶を評価スコアの低下として見つけ、update で直して回復するまでを実機で確認します。
AI Agentのトレースは、1回の実行にLLM CallやTool Callが数百単位で並ぶことも珍しくありません。実行が失敗したことは分かっても、原因になった1つの処理にたどり着くまでに時間がかかります。
LLMアプリを本番に出すなら、「危険な入力をどう弾くか」「望ましくない出力をどう止めるか」を決める必要があります。
Google CloudのModel ArmorやAWSのBedrock Guardrailsなど、クラウドのマネージドガードレールは導入しやすい一方で、認証、課金、運用基盤は各クラウドの仕組みに紐づきます。 マルチクラウドやオンプレミスを含む構成では、ガードレールの実行基盤を特定のクラウドに固定したくない場合もあります。
Langfuse の公式ドキュメントに掲載されている Cookbook「Migrating Data Between Langfuse Projects (Python SDK v4) 」を、4 つの移行パターンで実際に実行してみました。移行はおおむね成功しましたが、UI に出るものと出ないものが分かれ、見落としやすい落とし穴がいくつかありました。本記事では、特定の検証環境における観測結果と再現時の注意点を整理します。Cloud / セルフホスト / リージョンによる差分が Langfuse の正式仕様なのか、Feature flag や Preview UI・検証時点の実装差なのかは、本記事の範囲では切り分けていません。